先搞懂:什麼是物理 AI?
聊天機器人處理的是文字,物理 AI 則是要在真實世界裡動手做事的 AI,像是自駕車、工廠機器人、人形機器人,或是預測設備什麼時候會故障。它面對的不是網路上大量的文字,而是感測器、相機、測試台和遙測資料。一旦判斷錯誤,代價可能是撞車、停機或設備損壞。
十萬小時的完美資料,反而讓模型看不見
CoreWeave 是提供 AI 算力的雲端公司,2026 年 9 月 10 日推出「Physical AI Field Engineering」服務。這項服務派汽車、航太、機械背景的工程師直接進駐客戶團隊,用客戶手上的測試台結果、模擬輸出、產線感測器和即時遙測資料來建模。這支團隊和方法,來自 CoreWeave 在 2025 年收購的工程 AI 公司 Monolith。
Monolith 創辦人、現任 CoreWeave 物理 AI 資深副總裁 Richard Ahlfeld,在 Superintelligence 的書面訪談裡講得很直白:最常見的失敗,是「訓練集裡從來沒有真正重要的時刻」。要他預測車子什麼時候故障,卻只給他十萬小時一切正常的行駛資料,模型等於是瞎的。
道理其實不難:模型是從看過的例子學習的。資料裡從沒出現過故障,模型就不知道故障長什麼樣子。正常資料再多,也教不會它認出異常。
NEURA Gym:每天跑一輪的資料迴圈
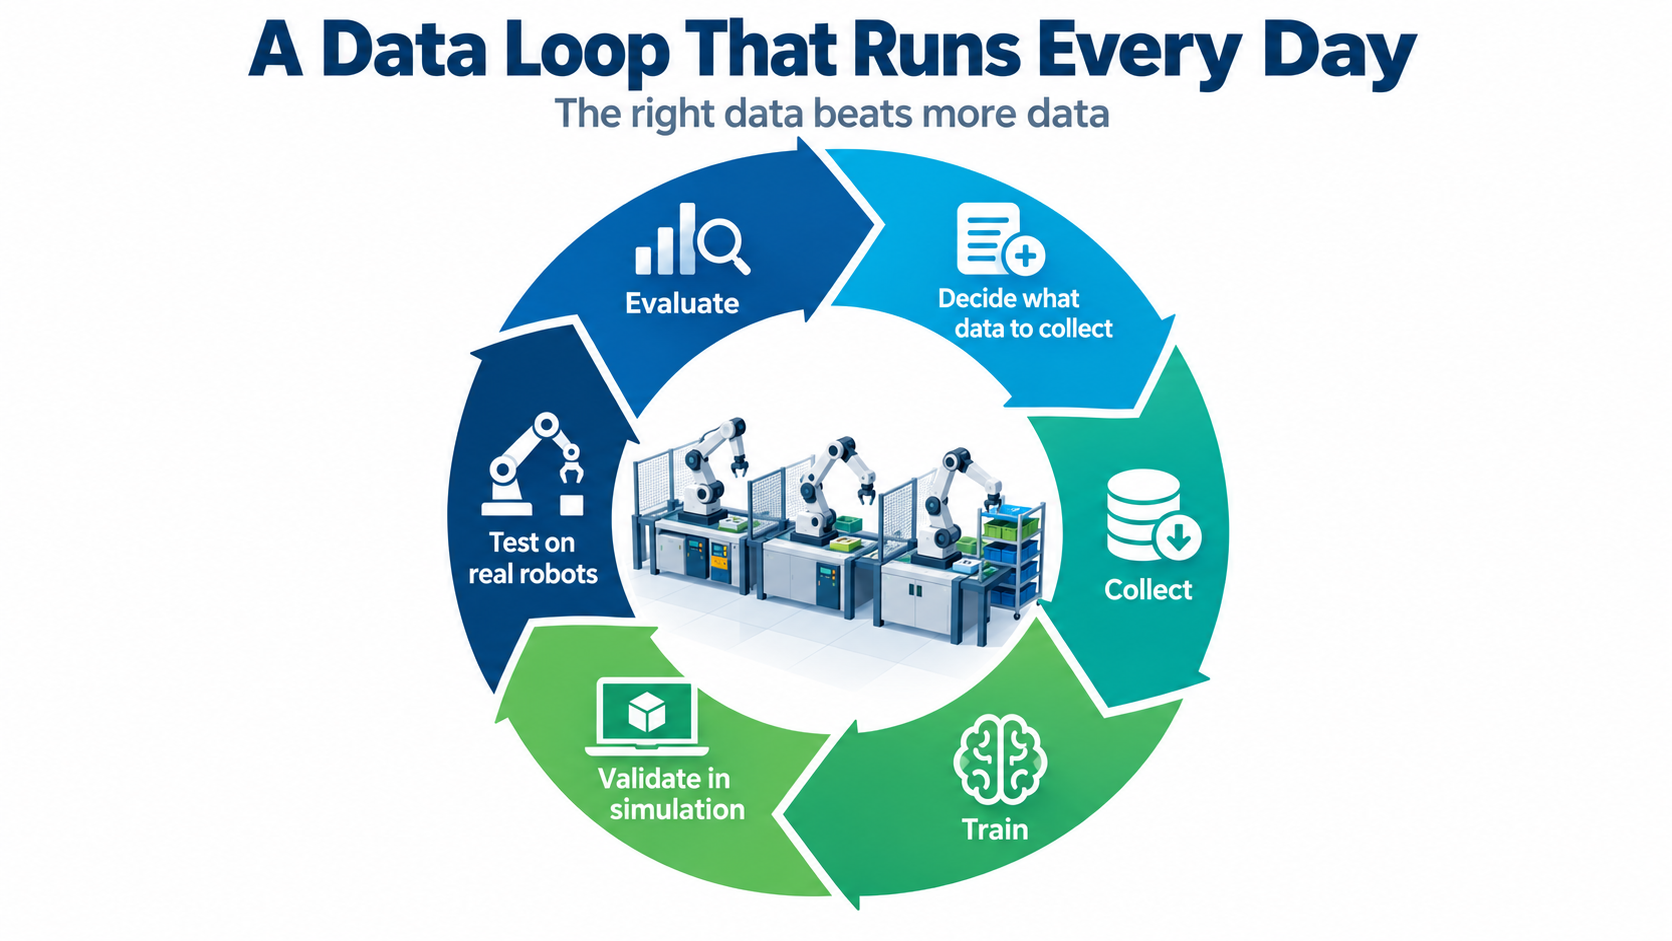
他以客戶 NEURA Robotics 為例。NEURA Gym 約有 100 個工作站,機器人在裡面試做客戶的真實任務,每天跑一輪:評估結果、決定要收什麼資料、收集、訓練、在模擬中驗證,再回到實體機器人上測試。
這套流程的結論是:資料的量,不如找到對的資料。現場工程師的價值,在於判斷哪些「邊緣案例」(很少發生、但一發生就出事的狀況)值得用合成資料補,哪些異常是訊號而不是雜訊。這是領域判斷,不是工具問題。
75 次迭代,換來 30 秒內的決策
另一個例子是 Aston Martin Aramco F1 車隊的無線電辨識系統。團隊以 7 小時的標註音訊為基礎,前後迭代了 75 次。Ahlfeld 說,這些迭代主要是讓模型撐得過引擎噪音、頭盔麥克風、時速 300 公里的風切、說不同語言的車手和車隊行話。
每一版都用評測工具 Weights & Biases Weave 檢驗,指標是字詞錯誤率和大型語言模型給的品質評分。系統先在卡達、阿布達比的正式賽事試跑,才全面上線。過去工程師要花好幾分鐘處理的問題,現在能在不到 30 秒的進站時間窗內解決。
不過要注意,訪談沒有公布錯誤率。「75 次」和「30 秒」描述的是流程和結果,不是準確度。
先驗證模擬,再談合成資料
真實世界的關鍵時刻很難等到,也很難錄到,所以業界常用模擬器,或能生成逼真場景的「世界模型」,產生合成資料來補。但 Ahlfeld 的第一條規則是:模擬必須先用受控的實測資料大量驗證。
他把合成資料能不能信分成兩類:
可以用合成資料補的:光照、幾何、運動這類物理模型擅長的落差。
還是得靠實體測試的:顆粒、液體、柔性材料、人類的隨機行為,以及硬體本身和模擬之間的差異。
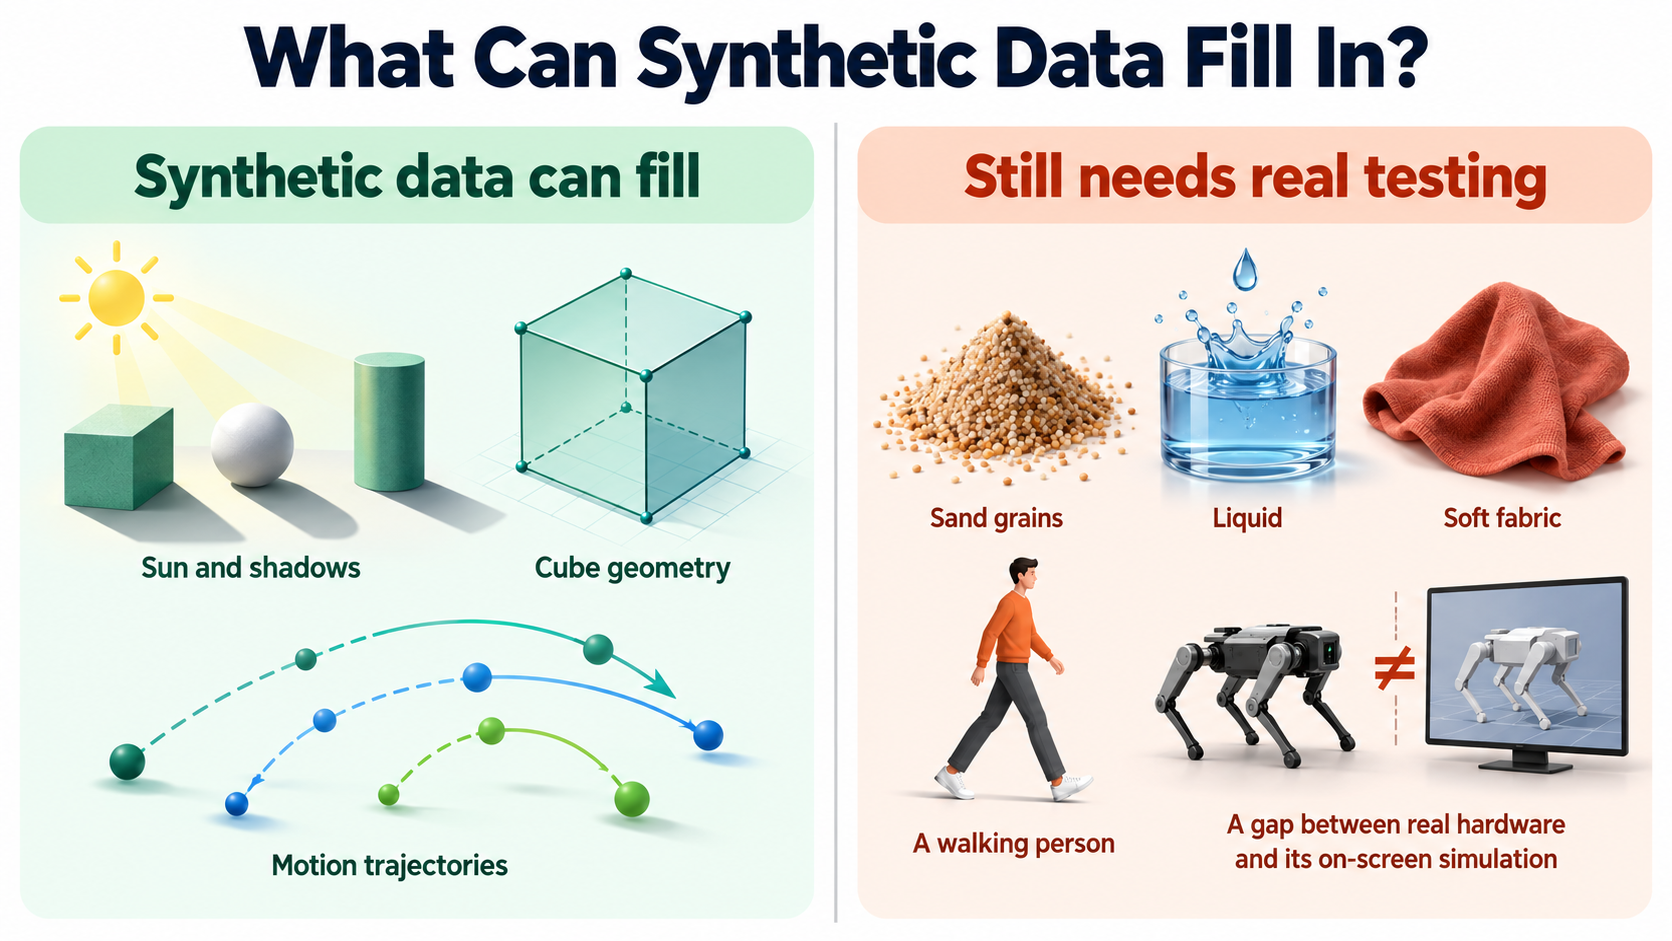
他舉了一台正在訓練的人形機器人為例。原始資料只有少數低光源片段,完全沒有陽光直射的畫面,任務直接失敗。團隊用 NVIDIA Cosmos 世界模型補上光線不理想的片段,重新訓練後,兩種情境都能處理。他也強調,這次會成功,是因為光照正好是世界模型擅長的。如果問題出在接觸、材料行為或磨損,就得回到真實測試。
對臺灣的意義
臺灣的能源轉型正處於大量示範和試車的階段,從碳捕存、氫能到各類新型發電設備,都在累積第一批現場資料。Ahlfeld 的經驗提醒我們三件事:
異常資料是資產,不是雜訊。試車期間的異常、停機和邊界工況,正是未來模型最缺的資料,應該有系統地記錄下來,而不是排除掉、只留下「漂亮」的穩態資料。
先驗證模擬,再拿模擬補資料。先用實測確認模擬可信的範圍。地下流體、材料腐蝕這類模擬的弱項,現場測試省不得。
AI 的建議要有人把關。Ahlfeld 主張,AI 對實體系統提出的建議,都要經過人審核並留下可追溯的紀錄。這對電廠和示範場來說同樣是底線。
與其追求最大的模型,不如先問一句:我們的資料裡,有沒有那個關鍵時刻?
來源
Superintelligence,"The most common failure isn't a bad model": CoreWeave's Richard Ahlfeld on physical AI(2026 年 10 月 4 日刊出):https://read.getsuperintel.com/p/the-most-common-failure-isn-t-a-bad-model-coreweave-s-richard-ahlfeld-on-physical-ai
CoreWeave,CoreWeave Launches Physical AI Field Engineering(2026-09-10):https://www.coreweave.com/news/coreweave-launches-physical-ai-field-engineering-to-turn-proprietary-data-into-production-ai
CoreWeave,AI Agents Decode F1 Radio in Near Real Time:https://www.coreweave.com/blog/how-ai-agents-on-coreweave-help-process-f1-radio-in-near-real-time
CoreWeave,CoreWeave's Stack for Physical AI:https://www.coreweave.com/blog/wayve-decart-neura-robotics-nissan-all-running-physical-ai-on-coreweave
NEURA Robotics,NEURA Gym:https://neura-robotics.com/neuragym/