そもそもAIエージェントとは何か
一般的なチャットAIは「聞かれたら答える」ものだ。これに対し、AIエージェント(agent)は自ら手を動かして作業をこなす。ソフトウェアをインストールし、ツールを呼び出し、プログラムを実行したうえで、結果をまとめて報告してくれる。Paper2Agentが行うのは、1本の論文をこうしたエージェントに変えることである。
読むだけの文書から、手を動かすエージェントへ
論文の多くは読むためのもので、使うためのものではない。論文の手法を自分の研究に応用しようとすれば、研究者はまず著者のソフトウェアをインストールし、データをどう入力するかを理解しなければならない。この段階だけで何日も足止めされることもある。
Earth.comが10月4日に報じたところによると、スタンフォード大学のポスドク研究員ジアチェン・ミャオ(Jiacheng Miao)氏と准教授ジェームズ・ゾウ(James Zou)氏らが開発したPaper2Agentは、この手間を省く。ユーザーが平易な言葉で質問すると、エージェントが論文そのもののコードを実行して答えるのだ。この研究は学術誌『Nature』に掲載された。
仕組みは3段階に分かれ、それぞれを1つのエージェントが担当する。
環境を構築する:1つ目のエージェントが、コードの実行に必要なソフトウェア環境をインストールする。
ツールを作る:2つ目のエージェントが、論文の主要な手法を、ほかのAIからも呼び出せるツールとしてパッケージ化する。
結果を検証する:3つ目のエージェントが、論文で報告された結果や図表と照らし合わせて各ツールをテストし、失敗を繰り返すツールは除外する。
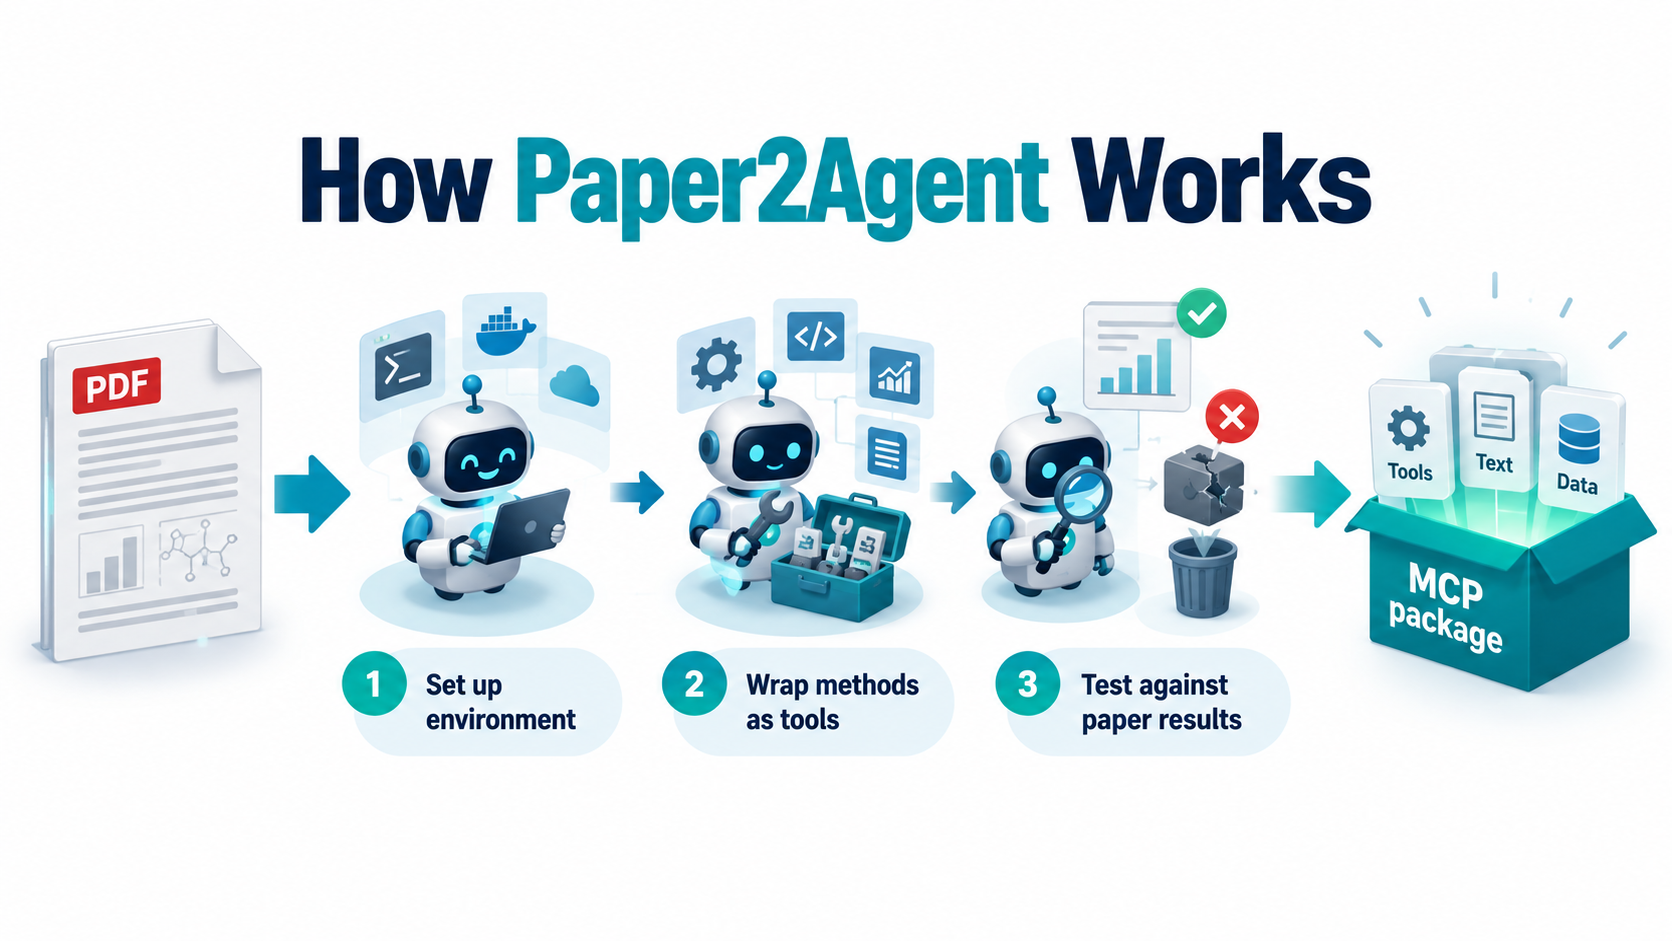
テストに合格したツールは、論文の本文、データ、よく使われる分析手順とともに、Model Context Protocol(MCP)でパッケージ化される。MCPは、AIが外部のツールやデータにアクセスするための共通規格で、いわばAIの世界の万能コンセントだ。ゾウ氏によれば、MCPを使うと、AIは論文をエージェントがアクセスしやすい形で表現できる。それは「ほとんどファイリングシステムのようなもの」だという。
数字で見る
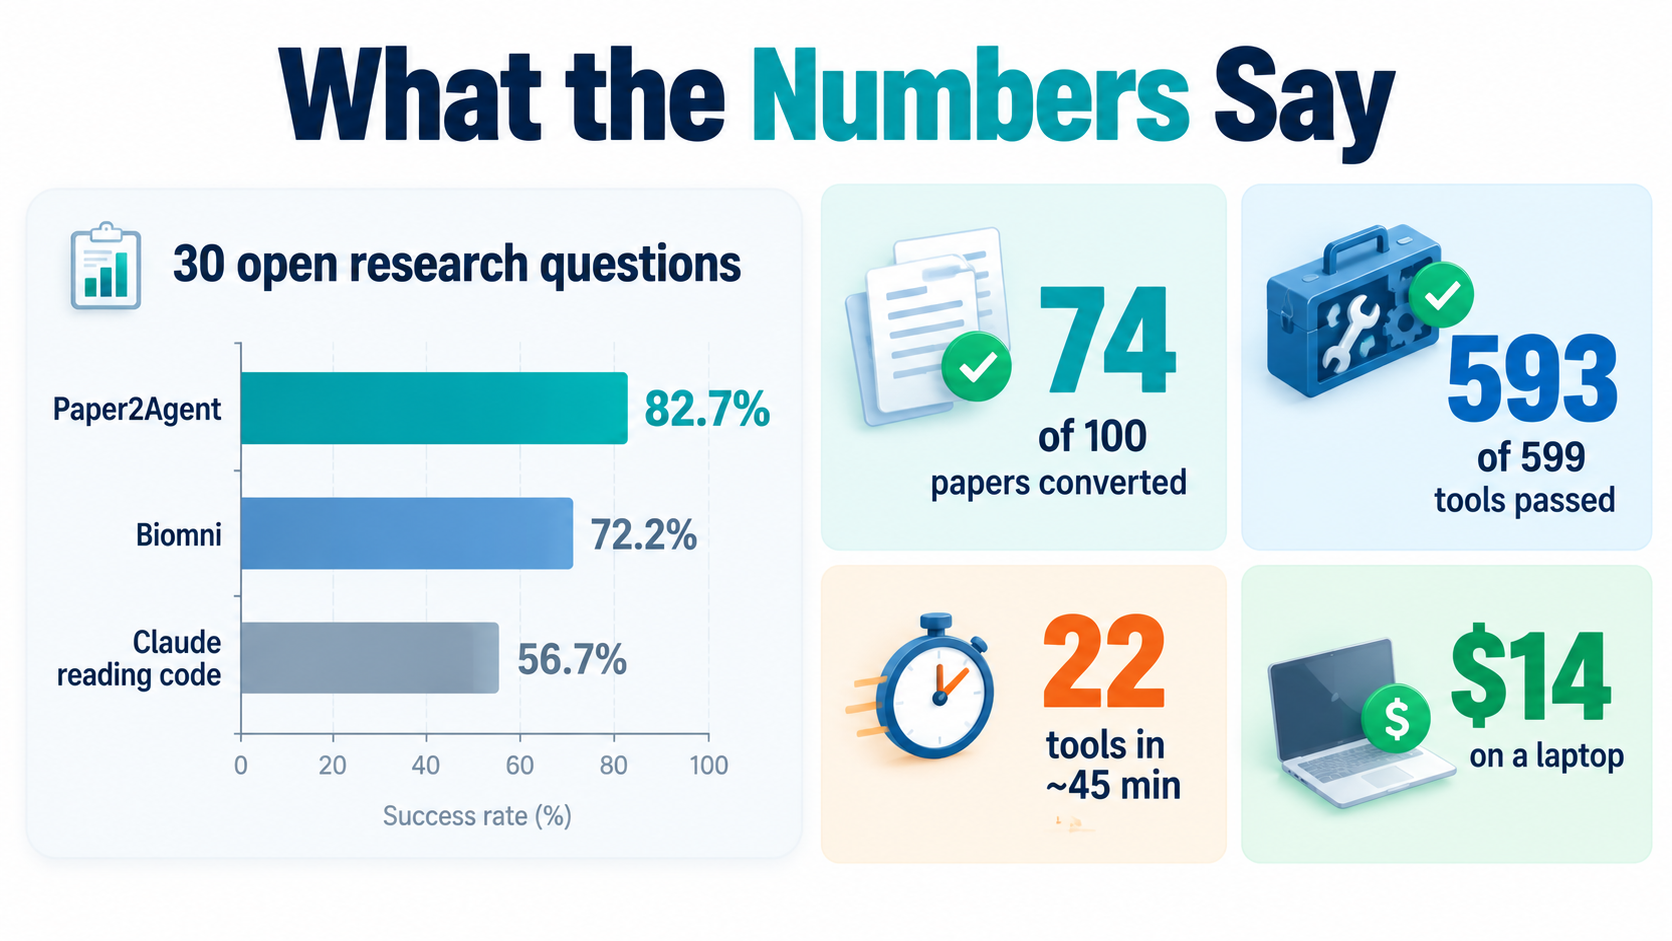
Google DeepMindのゲノムモデル「AlphaGenome」を例に取ると、システムは約45分で、人手を一切介さずに22個のツールを構築した。個人のノートPCで動作し、費用はわずか14ドルだった。
複数のツールを連携させる必要がある30問のオープンエンドな研究課題では、エージェントのスコアは82.7%に達した。コードを直接読ませたClaudeは56.7%にとどまり、別のAI研究アシスタントであるBiomniは72.2%だった。
規模を広げたテストでは、計算生物学の論文100本のうち74本がエージェント化に成功し、システムが提案した599個のツールのうち593個がテストに合格した。300問でのスコアは91.2%で、コードを直接読ませた場合の80.3%を上回った。失敗の主な原因は、コードがない、データがない、あるいはソフトウェアをインストールできないことだった。
3つのエージェントが連携して乾癬の遺伝子を探す
最も注目を集めた実験は、3つの論文エージェントに役割を分担させたものだ。まずAlphaGenomeエージェントが、CD4+ T細胞(免疫反応を調節する白血球の一種)では、乾癬に関連するゲノム上の部位が、近くにあるほかのどの遺伝子よりもGPR137という遺伝子に強く影響すると予測した。
研究チームは次に、既存の2本の論文から作ったエージェントをつないでデータを照合した。その結果、5つの候補遺伝子のうち一致したのはGPR137だけで、しかもそれは刺激を受けた細胞でのみ見られた。この過程では新たな実験は一切行われておらず、使われたのはすべて既存のデータだった。
限界もはっきりしている
著者らは、エージェントは独立した科学者ではないと強調する。研究の方向を決めるのはあくまで研究者であり、証拠を評価するのも人間だ。エージェントを公開した人は、その土台となるソフトウェアを保守し続けなければならない。セキュリティや所有権、学術的な功績の帰属をどう扱うかも、まだ答えが出ていない。著者らはまた、将来は学術誌が論文に「エージェントの利用可能性(agent availability)」の項目を求めるようになるかもしれないと提案している。
台湾にとっての意味
研究機関にとって、Paper2Agentで最も注目すべきは精度ではなく、失敗に終わった26本の論文のほうだ。原因は、コードがない、データがない、実行環境を構築できない、のいずれかだった。
台湾の公的研究機関や大学は、毎年大量のプロジェクト報告書や実験データを生み出している。だがプログラムやデータは個人のパソコンに散らばっていることが多く、プロジェクトが終わると誰も保守しなくなる。知識管理が「PDFのアーカイブ」にとどまっていれば、今後広がるエージェント型の働き方にはつながらない。
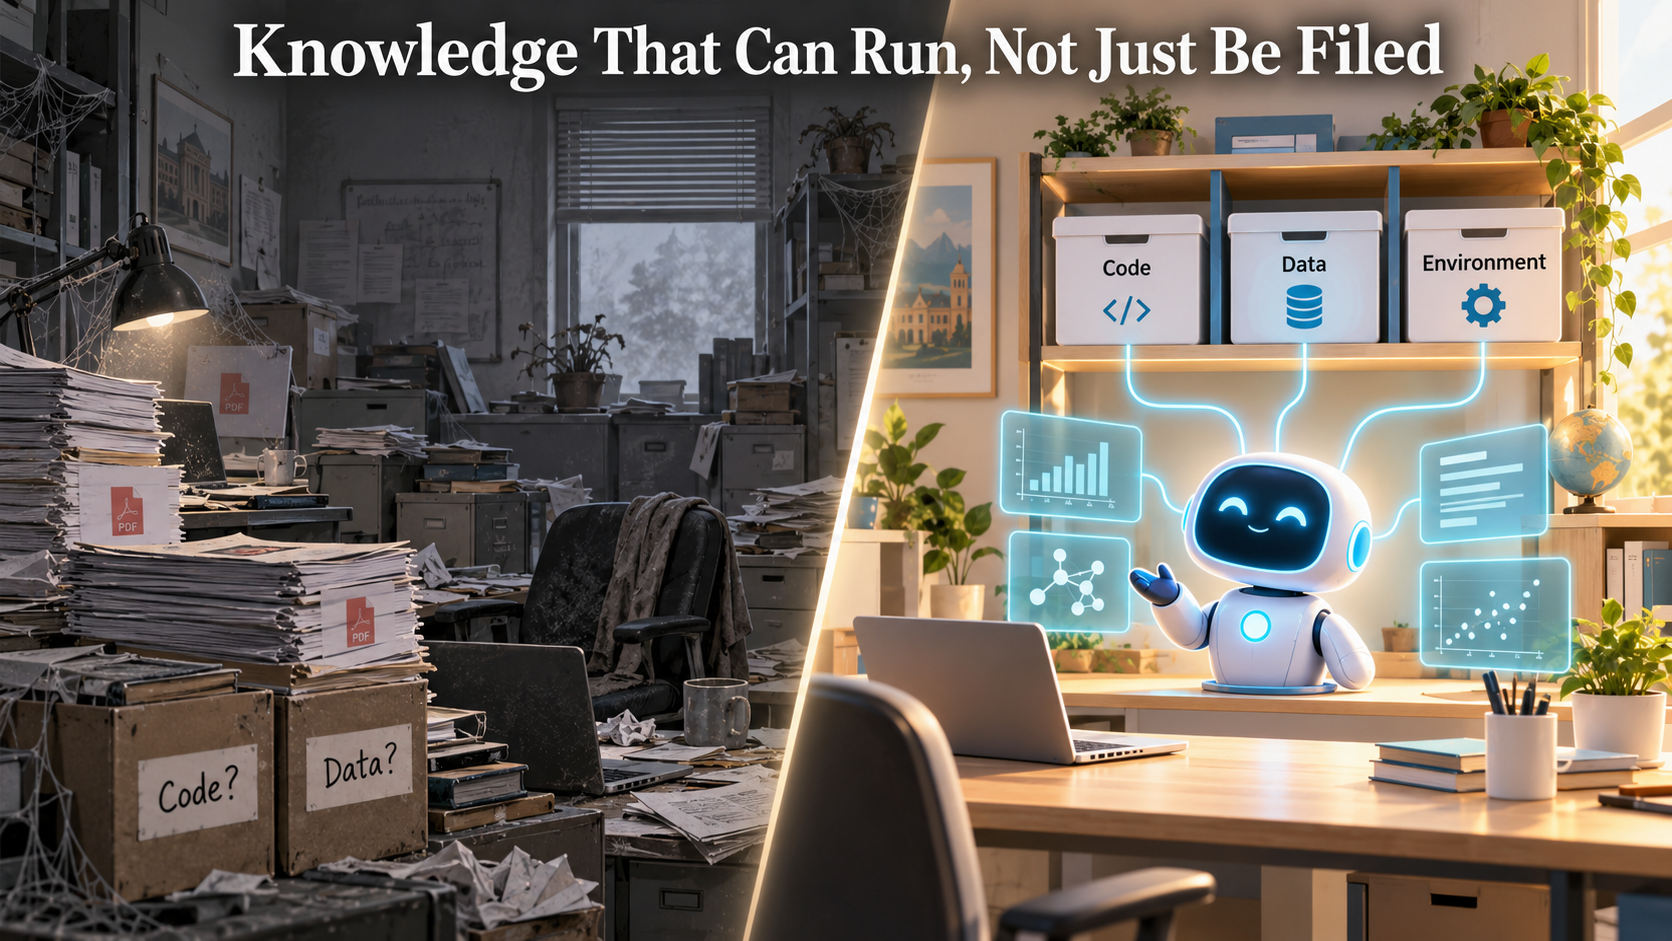
現実的な第一歩として、取り組むべきことは2つある。
コード、データ、実行環境を研究成果の一部として納品する。報告書を1本提出して終わりにしない。
まず内部データのアクセス権限、保守の責任、功績の帰属に関するルールを定める。報告書に「語らせる」のはその後だ。
出典
Earth.com「Research papers can now become AI agents that answer questions」(2026年10月4日):https://www.earth.com/science/research-papers-can-now-become-ai-agents-that-answer-questions/
Nature News「AI tool turns any paper into an 'agent' that can collaborate and answer complex queries」(2026年9月16日):https://www.nature.com/articles/d41586-026-02899-2
論文:Miao, J., Davis, J. R., Zhang, Y., Pritchard, J. K. & Zou, J., Nature (2026):https://doi.org/10.1038/s41586-026-11044-y