そもそもフィジカルAIとは何か
チャットボットが扱うのは文字だ。これに対し、フィジカルAIは現実世界で実際に体を動かして作業をこなすAIである。自動運転車、工場のロボット、人型ロボット、あるいは設備がいつ故障するかを予測するシステムなどがこれにあたる。相手にするのはネット上の膨大なテキストではなく、センサー、カメラ、試験台、テレメトリーのデータだ。判断を誤れば、衝突事故や稼働停止、設備の損傷を招きかねない。
10万時間の完璧なデータでも、モデルには何も見えない
AI向けの計算資源を提供する米クラウド企業CoreWeaveは、2026年9月10日に「Physical AI Field Engineering」サービスを開始した。自動車、航空宇宙、機械分野の経験を持つエンジニアを顧客のチームに直接送り込み、試験台の結果、シミュレーション出力、生産ラインのセンサー、リアルタイムのテレメトリーなど、顧客がすでに持っているデータでモデルを構築する。このチームと手法は、CoreWeaveが2025年に買収したエンジニアリングAI企業Monolithから引き継いだものだ。
Monolithの創業者で、現在はCoreWeaveのフィジカルAI担当シニアバイスプレジデント(SVP)を務めるリチャード・アールフェルト(Richard Ahlfeld)氏は、Superintelligenceの書面インタビューで率直にこう語る。最もよくある失敗は、「本当に重要な瞬間を一度も含んでいない訓練データ」だ。「車がいつ故障するかを予測してほしいと言われても、渡されたのが10万時間分の完璧な走行データだけなら、私には何も見えない」。
理屈は難しくない。モデルは見たことのある例から学ぶ。データに故障が一度も出てこなければ、モデルは故障がどういうものかを知りようがない。正常なデータをいくら積み上げても、異常を見分けることは教えられないのだ。
NEURA Gym:毎日一巡するデータのループ
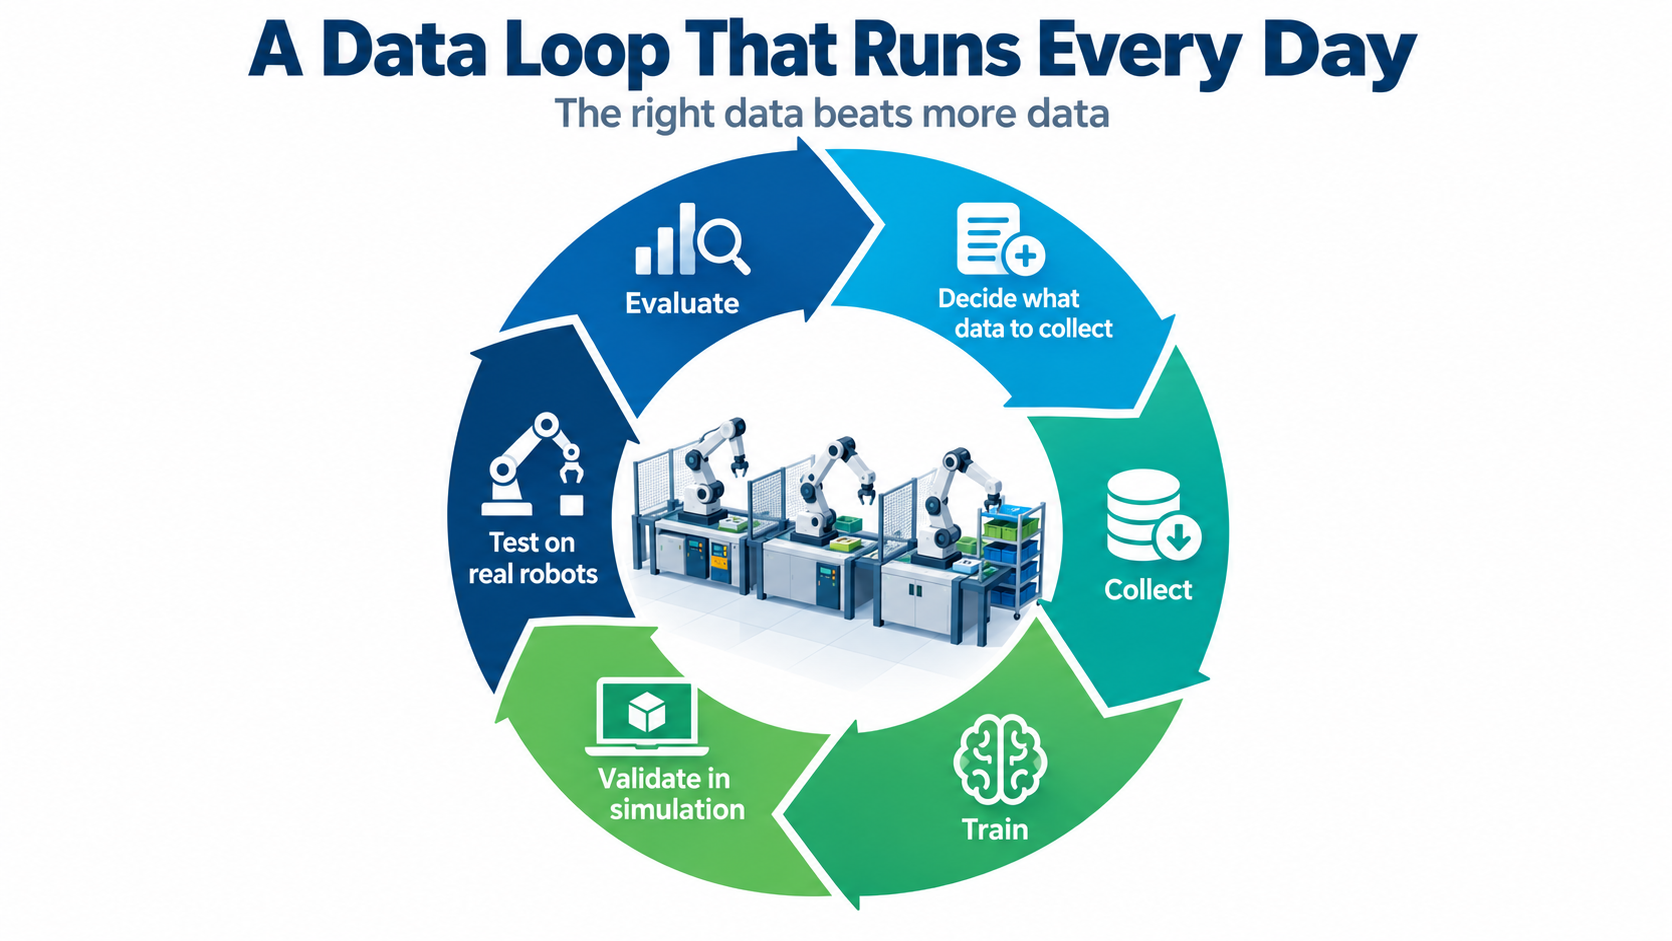
同氏は顧客であるNEURA Roboticsの例を挙げる。NEURA Gymには約100のセル(作業区画)があり、ロボットが顧客の実際のタスクに挑む。ループは毎日一巡する。結果を評価し、収集すべきデータを決め、収集し、学習させ、シミュレーションで検証し、再び実機のロボットでテストする。
このプロセスから導かれた結論は、データの量よりも、適切なデータを見つけることのほうが重要だというものだ。現場エンジニアの価値は、どの「エッジケース」(めったに起きないが、起きれば大きな問題になる状況)を合成データで補うべきか、どの異常がノイズではなくシグナルなのかを見極めることにある。これはドメインに関する判断であり、ツールの問題ではない。
75回の改良で、30秒以内の判断が可能に
もう一つの例が、アストンマーティン・アラムコF1チームの無線認識システムだ。チームは7時間分のアノテーション(注釈)付き音声をもとに、75回にわたって改良を重ねた。アールフェルト氏によると、改良の大半は、エンジン音、ヘルメットのマイク、時速300kmの風切り音、多言語を話すドライバー、チーム内の略語といった音響条件に、モデルが耐えられるようにするためのものだった。
各バージョンは評価ツール「Weights & Biases Weave」で、単語誤り率(WER)と、大規模言語モデル(LLM)による品質スコアを指標に検証した。さらにカタールとアブダビのレースで実戦投入して試したうえで、本格運用に移行した。かつてエンジニアが数分かけていた問題を、今では30秒足らずで閉じるピットウィンドウの中で解決できる。
ただし注意したいのは、インタビューでは誤り率が公表されていない点だ。「75回」と「30秒」が示しているのはプロセスと結果であり、精度ではない。
合成データの前に、まずシミュレーションを検証する
現実世界の重要な瞬間は、待っていてもなかなか訪れず、記録するのも難しい。そのため業界では、シミュレーターや、リアルな場面を生成できる「世界モデル」で合成データを作り、穴を埋めることが多い。だがアールフェルト氏の第一のルールは、管理された条件下で取得した実データセットを使って、シミュレーションを徹底的に検証しなければならないというものだ。
同氏は、合成データを信頼できるかどうかで次の二つに分けている。
合成データで補えるもの:照明条件、幾何形状、動きなど、物理モデルが得意とする領域のギャップ。
依然として実機試験が必要なもの:粒状物、液体、柔らかい素材、予測しにくい人間の行動、そしてハードウェアそのものとシミュレーションとの違い。
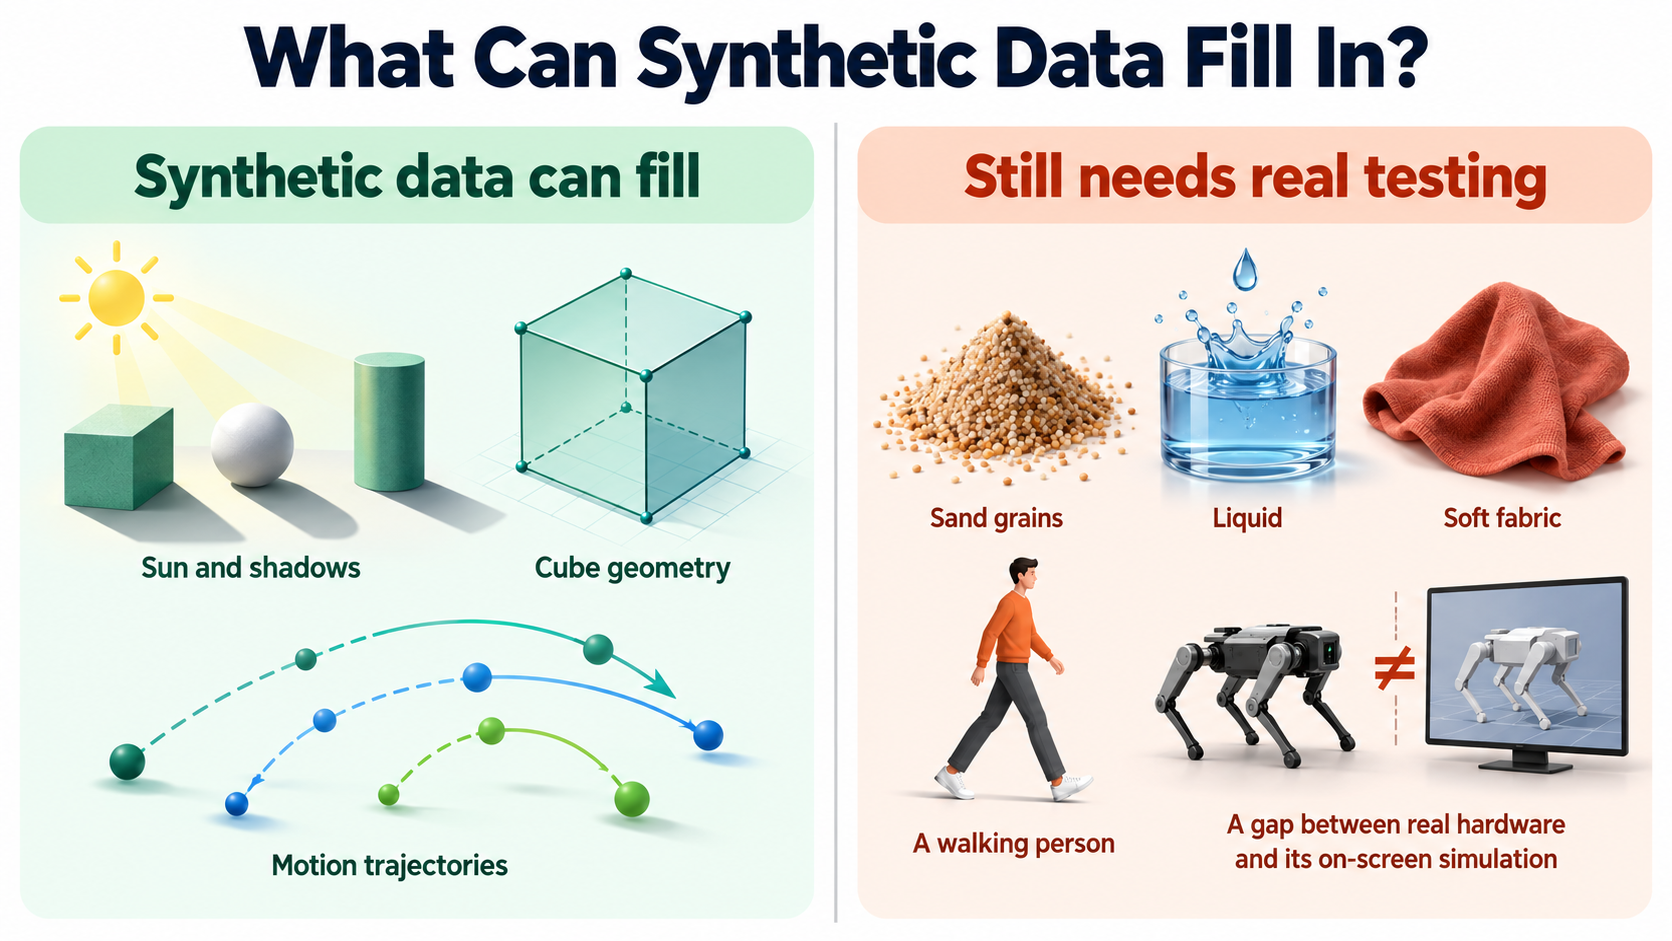
同氏は、現在訓練中の人型ロボットを例に挙げる。元の訓練データには低照度のエピソードがわずかしかなく、直射日光下のものは一つもなかったため、ロボットはこうした条件のタスクにまったく対応できなかった。チームはNVIDIAの世界モデル「Cosmos」を使って理想的でない照明条件のエピソードを追加し、再学習させた結果、どちらの条件にも対応できるようになった。同氏は、これがうまくいったのは照明こそ世界モデルが正確に再現できる分野だからだと強調する。失敗の原因が接触や材料の挙動、摩耗にあったなら、実環境での試験に戻るしかなかったという。
台湾にとっての意味
台湾のエネルギー転換は、実証や試運転が数多く行われる段階にある。CCS(CO2回収・貯留)から水素、さまざまな新型発電設備まで、各プロジェクトが最初の現場データを蓄積しつつある。アールフェルト氏の経験は、次の3点を示唆している。
異常データはノイズではなく資産である。試運転中の異常、停止、運転限界付近の条件こそ、将来のモデルに最も不足するデータだ。除外して「きれいな」定常データだけを残すのではなく、体系的に記録しておくべきである。
シミュレーションでデータを補う前に、まずシミュレーションを検証する。実測によって、シミュレーションを信頼できる範囲を確かめておく。地下の流体挙動や材料の腐食など、シミュレーションが苦手とする領域では、現場試験を省くことはできない。
AIの提案には人のチェックが欠かせない。アールフェルト氏は、物理システムに対するAIの提案はすべて人が審査し、追跡可能な記録を残すべきだと主張する。これは発電所や実証サイトにとっても譲れない一線だ。
最大のモデルを追い求める前に、まず問うべきことがある。私たちのデータに、その重要な瞬間は含まれているだろうか。
出典
Superintelligence「"The most common failure isn't a bad model": CoreWeave's Richard Ahlfeld on physical AI」(2026年10月4日掲載):https://read.getsuperintel.com/p/the-most-common-failure-isn-t-a-bad-model-coreweave-s-richard-ahlfeld-on-physical-ai
CoreWeave「CoreWeave Launches Physical AI Field Engineering」(2026年9月10日):https://www.coreweave.com/news/coreweave-launches-physical-ai-field-engineering-to-turn-proprietary-data-into-production-ai
CoreWeave「AI Agents Decode F1 Radio in Near Real Time」:https://www.coreweave.com/blog/how-ai-agents-on-coreweave-help-process-f1-radio-in-near-real-time
CoreWeave「CoreWeave's Stack for Physical AI」:https://www.coreweave.com/blog/wayve-decart-neura-robotics-nissan-all-running-physical-ai-on-coreweave
NEURA Robotics「NEURA Gym」:https://neura-robotics.com/neuragym/